Choisissez le fuseau horaire
Le fuseau horaire de votre profil:
L’édition 2026 des Journées Informatiques de l'IN2P3/IRFU aura lieu du lundi 23 novembre 2026 à 14h au jeudi 26 novembre 2026 à 12h.
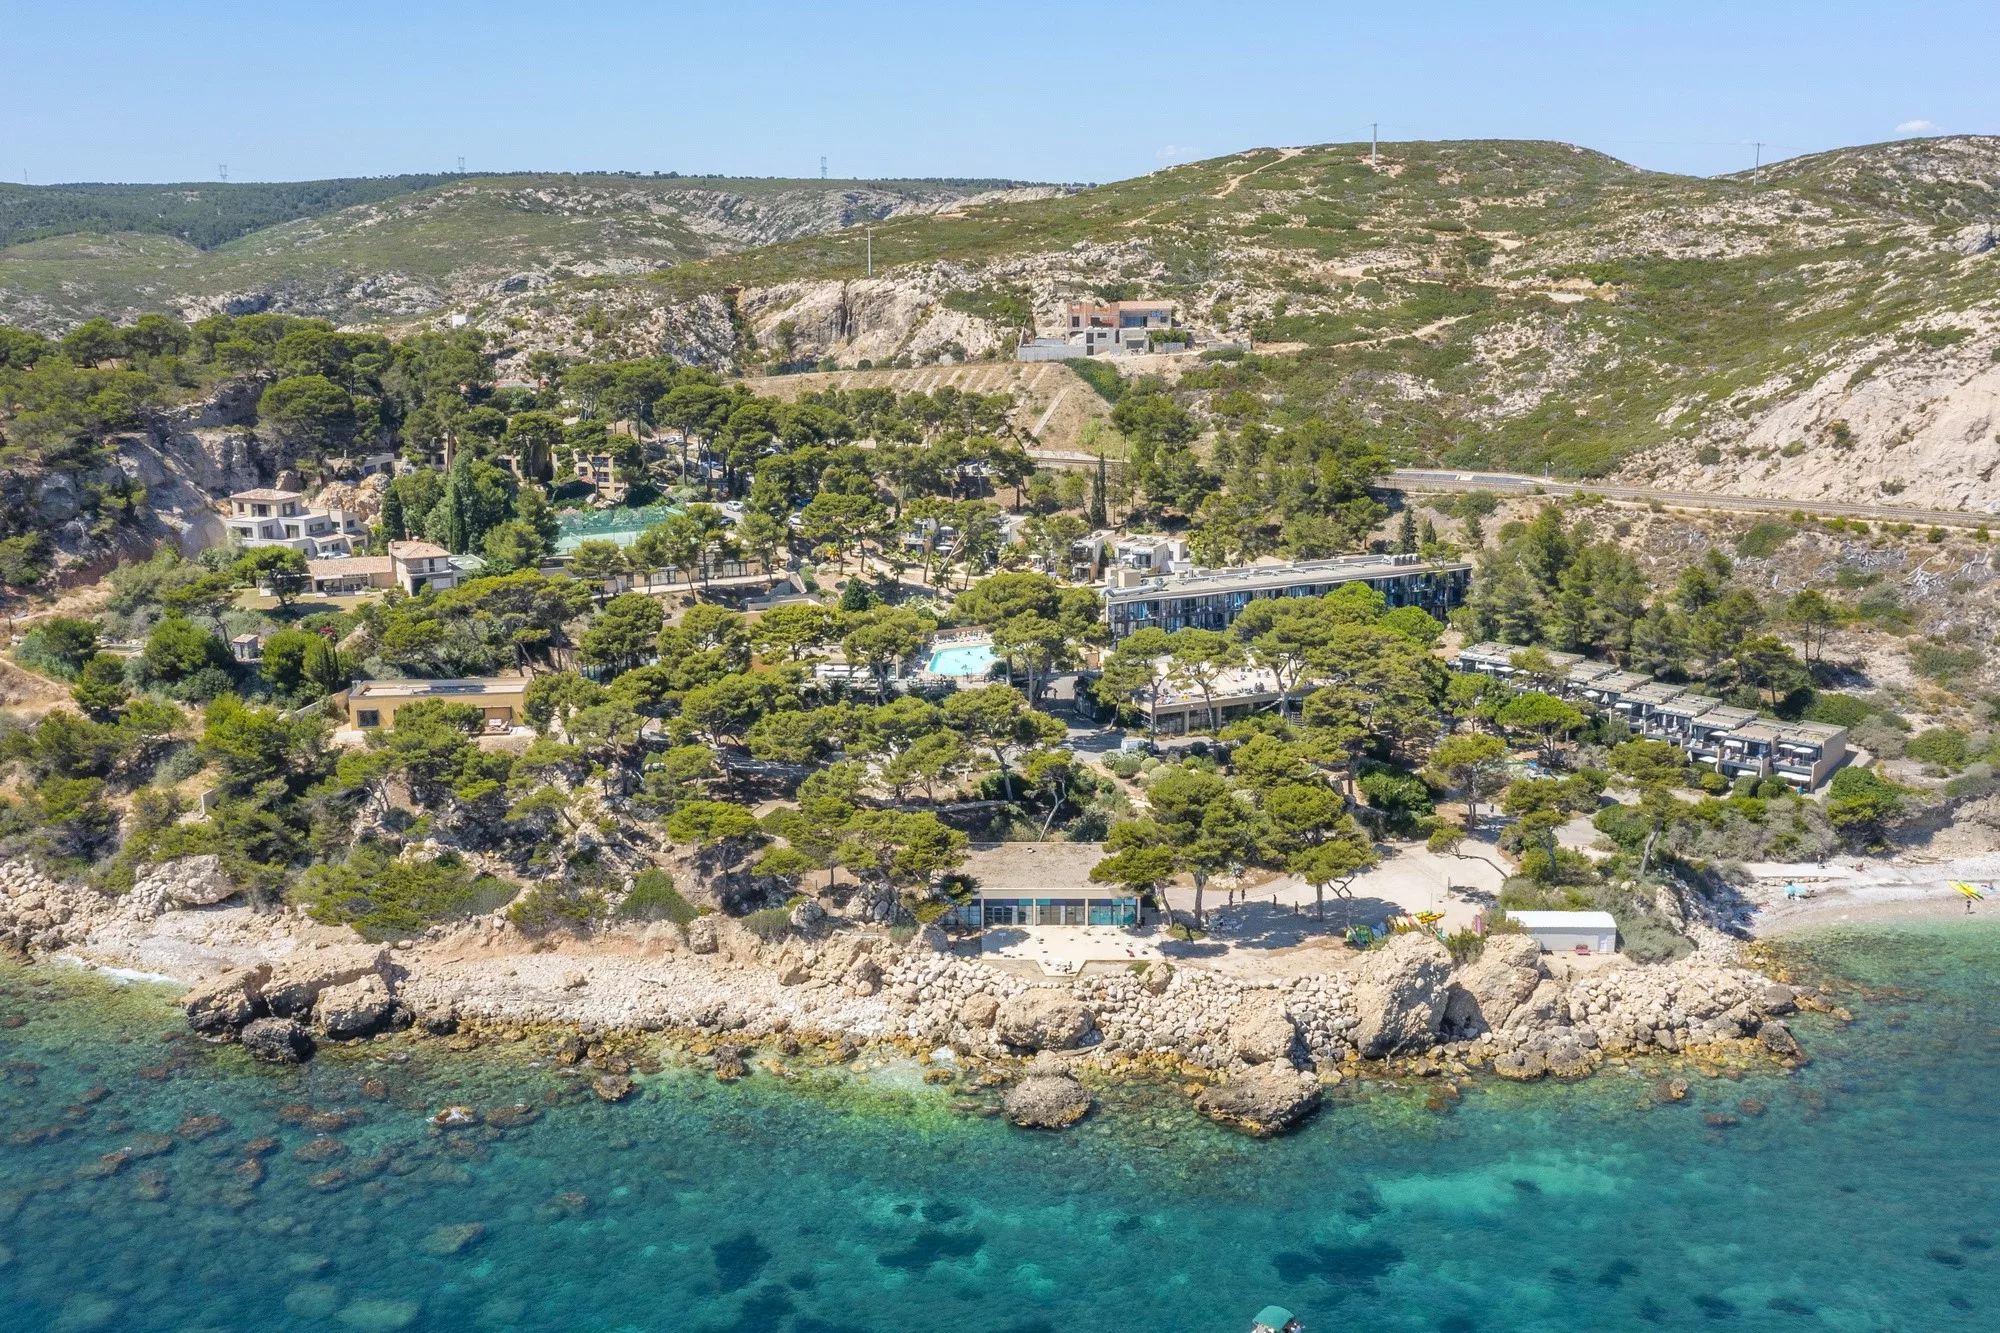
Ces 16èmes Journées Informatiques se tiendront uniquement en présentiel au Miléade de Carry-le-Rouet. Le nombre de places maximum est fixé à 120 personnes, l'inscription est obligatoire et soumise à approbation. La priorité sera donnée aux collègues qui resteront les 4 jours complets.
Pour cette édition, nous avons privilégié les méthodologies transverses que sont l'IA comme aide au développement et le DevSecOps.
Comme à chaque édition les JI IN2P3-IRFU accueillent toutes les propositions couvrant l’ensemble de nos métiers (DEV, ASR et informatique instrumentale) sur des sujets divers.
Nous vous invitons dès à présent à soumettre vos résumés de contributions. Différents formats vous sont proposés :
La date limite d'inscription est fixée au 14 septembre 2026, à midi.
La date limite de soumission des contributions est fixée au 30 septembre 2026, à minuit.
Le temps de trajet est d'environ 45 minutes.
Merci de réserver vos trains en fonction de ces horaires.
Les présentations seront enregistrées, et proposées par la suite par le service du webcast IN2P3. Souhaitant un mode en présentiel uniquement, il ne sera pas proposé de lien de visioconférence pour suivre ces journées à distance.
Une activité de randonnée sera proposée le mercredi, penser à prendre des baskets.
En décembre 2025, le CNRS a mis à disposition de ses personnels un agent conversationnel en intelligence artificielle générative. Cet outil, Emmy, est basé sur l'offre Vibe Entreprise de Mistral AI, et est le résultat de plus d'un an de travail.
Avec l'IDRIS, nous avons mis en place une solution interne en beta-test sur quelques centaines d'utilisateurs clés dès décembre 2024 afin d'obtenir des retours des utilisateurs en condition réelle, et d'estimer l'usage qui est fait de ce genre d'outils.
En parallèle, une phase d'étude a été menée afin de comparer les différentes solutions d'hébergement de ce type de service : "on premise", utilisation d'API en mode "LLM-as-a-service" par différents opérateurs, location de GPU dans le cloud. Cette étude prend en compte les besoins exprimés par les utilisateurs, et une estimation de l'usage réel.
Au final, le choix s'est porté sur la solution Vibe Entreprise de Mistral AI en mode Saas, que les 34 000 agents CNRS peuvent utiliser via le système d'authentification du CNRS (Janus).
Je présenterai le contexte de cette étude, les fonctionnalités offertes aujourd'hui par l'outil, avec des démonstrations (bibliothèques, skills, ...), ainsi que les fonctionnalités à venir.
Dans le cadre du projet européen EVERSE, un corpus de bonnes pratiques logicielles a été assemblé et baptisé RSQKit. Les recommandations listées dans ce corpus ne sont pas forcément simples à appréhender, notamment pour un public non averti. Nous nous sommes demandé si l'IA générative pouvait nous y aider. Nous proposons un retour d'expérience sur l'analyse du code CLASS, outil de simulation dynamique du cycle du combustible nucléaire. Nous nous appuierons sur des ressources techniques si possibles libres et souveraines, autour de l'outil OpenCode.
https://everse.software/RSQKit/
https://gitlab.in2p3.fr/sens/CLASS/
https://opencode.ai/
Un modèle de fondation est un modèle pré-entraîné sur un très grand volume de données, conçu pour être ensuite réutilisé sur des tâches variées sans ré-entraînement spécifique. Ce paradigme est le même que celui popularisé par les grands modèles de langage (LLM, type GPT), mais appliqué ici à des données scientifiques plutôt qu'à du texte. L'astrophysique produit aujourd'hui des masses de données considérables, ce qui en fait un candidat intéressant pour ce genre d'approches. Plusieurs modèles ont vu le jour ces dernières années, notamment les modèles de fondation AstroCLIP (Parker et al. 2024), AstroPT (Smith et al. 2024) et AION (Parker et al. 2025), ainsi qu'un jeu de données multimodales (Multimodal Universe Collaboration et al. 2024).
Je proposerai un retour d'expérience construit autour de trois applications concrètes. Dans un premier temps, je présenterai le travail réalisé lors du hackathon AISSAI AstroInfo 2025, où nous avons comparé les représentations apprises par les trois modèles susmentionnés sur des images Euclid Q1 et des spectres DESI DR1. Ensuite, je reviendrai sur les résultats obtenus par Ronceray et al. (2026), qui ont étendu ce travail à la détection d'anomalies non supervisée. Je conclurai enfin sur leur usage génératif pour synthétiser des propriétés physiques de galaxies et d'étoiles, développé dans le cadre du projet ANR DISPERS via un projet mené avec le CentraleDigitalLab (Centrale Méditerranée), aboutissant au package mockcraft.
Les écoles Gray Scott traitent de l'optimisation des calculs dans divers langages de programmation tels que C++, Rust, Fortran et Python, ainsi que de nombreuse bibliothèques de calcul. Ce sont des écoles d'été intensives de deux semaines qui ont eu un succès assez inattendu.
L'idée est de revenir sur les éditions de l'école Grays Scott, les partenariats et les collaboration qu'elles ont permise, en fournir un bilan et montrer les nouvelles écoles en préparation.
Face à la course aux modèles toujours plus grands, une autre voie existe : ouvrir le « cerveau » d'un modèle existant et l'opérer. Cette présentation propose une introduction pratique à la neurochirurgie artificielle, c'est-à-dire l'ensemble des techniques permettant de disséquer, modifier et réassembler des réseaux de neurones pour les spécialiser sur une tâche précise. Après un bref rappel de l'anatomie d'un transformeur, nous passerons en revue les principaux actes chirurgicaux. L'imagerie permet d'inspecter les activations, l'ablation retire des couches ou des têtes d'attention, et la greffe connecte un encodeur visuel ou audio à un modèle de langage. Viennent ensuite les implants (adaptateurs LoRA), la rééducation (distillation, réentraînement léger) et enfin la compression par quantification. Illustrée par des exemples concrets sur de très petits LLM, VLM et modèles audio, la présentation montrera qu'avec des moyens modestes, on peut obtenir des modèles spécialisés et frugaux, déployables en edge, au plus près des instruments et des données. Aucune compétence médicale requise.
UpGLADE: an Open Data Galaxy Catalogue
Over the next two years, the UpGLADE project aims to provide a comprehensive, living galaxy catalogue to the astronomical community. While designed for gravity wave cosmology and measurement of the Hubble constant, UpGLADE's all-sky coverage, efficient queries, and interoperable access tools will support a variety of research in cosmology and extragalactic astronomy. This presentation reviews UpGLADE's science and technical goals and briefly summarises our approach.
The presentation will be in English.
UpGLADE: un catalogue des galaxies ouvert
Pendent les deux prochaines années, le projet UpGLADE a pour but mettre à la disposition de la communauté astronomique un catalogue des galaxies complet et évolutif. Il est conçu pour la cosmologie des ondes gravitationnelles et la mesure de la constante de Hubble. Mais, sa couverture de tout le ciel, ses requêtes performantes, et ses outils d'accès interopérables accompagneront divers travaux de recherche en cosmologie et astronomie extragalactique. Cet exposé passe en revue les objectifs scientifiques et techniques d'UpGLADE et résume brièvement notre démarche.
L'exposé sera en anglais.
Le futur observatoire spatial d'ondes gravitationnelles, LISA (Laser Interferometer Space Antenna), sera capable de détecter un grand nombre de signaux provenant de sources astrophysiques variées, telles que les fusions de trous noirs supermassifs, les binaires de naines blanches, etc. Ces signaux se mèlent entre eux et au bruit, ce qui rend nécessaire un ajustement global des données enregistrées, dit global-fit, pour caractériser les propriétés physique des sources. Notre équipe inter-laboratoire a développé un prototype de global-fit modulaire sous le nom de Gee-Moo, qui a été testé sur un jeu de données simulées. Je vais présenter mon travail sur son amélioration, en particulier sur le nouveau système de configuration, qui rend le code plus facile à maintenir, à optimiser et à étendre.
Lancée le 22 juin 2024, la mission spatiale SVOM (Space-based multi-band astronomical Variable Objects Monitor) observe en Gamma et X le ciel à la recherche de sursauts gamma.
À son bord, le télescope gamma à masque codé ECLAIRs est chargé de détecter et localiser ces sursauts. Le pipeline de traitement de données de l'instrument ECLAIRs nommé ECPI (ECLAIRs PIpeline) est développé depuis plus de 10 ans au laboratoire APC.
Dans cette présentation, je ferai un retour d'expérience sur le refactorisation de la composante imagerie (IMAG) du pipeline, une composante du pipeline avec du code datant du début du développement d'ECPI.
Cette présentation sera aussi un retour d'expérience sur l'utilisation de l'IA pour l'aide au code dans cette tâche de refactorisation. Plus spécifiquement, ECPI étant un projet fermé et compte tenu des règles régissant l'utilisation de l'IA au CNRS, seules des solutions d'IA compatibles avec ces contraintes ont été utilisées et testées : Logiciels open source (Mistral Vibe CLI, extensions Vscode etc.), clés API "souveraines" (AlbertAPI, clés Mistral via Emmy).
Les méthodes basées sur des réseaux de neurones sur graphes (Graph Neural Networks, GNN) ont récemment été développées et utilisées avec succès pour la reconstruction de traces de particules dans le détecteur ATLAS [1, 2, 3].
Elles ont démontré une vitesse de reconstruction compatible avec les contraintes opérationnelles du HL-LHC et avec la très grande quantité de données supplémentaires qui sera enregistrée par ITk, le futur détecteur interne d'ATLAS, alors que les algorithmes de reconstruction actuels ne seront pas suffisamment rapides pour traiter ces données.
Pour chaque événement de collision, la première étape consiste à construire un graphe dont les nœuds sont les traces (hits) laissées par les particules dans le détecteur et les arêtes les connexions possibles entre ces hits, en s'appuyant sur la géométrie du détecteur et sur une Module Map. Cette étape a été accélérée grâce à une implémentation massivement parallélisée sur GPU [4, 5].
Dans la deuxième étape, un GNN attribue à chaque arête du graphe un score, qui est une pseudo-probabilité que cette arête corresponde à un segment de trace. La dernière étape consiste à segmenter le graphe en éliminant les arêtes dont le score est inférieur à un certain seuil, puis à relier les hits restants pour reconstruire les candidats traces. Cette étape était jusqu'à présent effectuée sur CPU par un algorithme séquentiel de parcours de graphe et constituait un goulot d'étranglement en termes de temps de calcul, car elle était trop lente par rapport aux autres parties de la chaîne.
Plusieurs tentatives de parallélisation sur GPU ont alors vu le jour. L'une d'elles, Edge Layer Connector, reconstruit les traces en éliminant d'abord les segments ayant les plus mauvais scores, ce qui réduit fortement la taille du graphe, puis classe les segments par couches. Enfin, pour lever les ambiguïtés entre les chemins d'une couche à une autre, une double passe est effectuée, de l'extérieur du détecteur vers l'intérieur puis dans le sens inverse, en se basant sur le produit des scores donnés par le GNN, pondéré par la longueur de la chaîne. Les traces obtenues sont comparées à celles de l'algorithme séquentiel de référence tournant sur CPU.
Les temps de calcul obtenus sont du même ordre de grandeur que ceux des autres parties de la chaîne, ce qui permet d'envisager une reconstruction de traces viable pour le traitement des données du HL-LHC.
(1) Towards a realistic track reconstruction algorithm based on graph neural networks for the HL-LHC, Catherine Biscarat, Sylvain Caillou, Charline Rougier, Jan Stark and Jad Zahreddine, EPJ Web Conf., Volume 251, 2021, 25th International Conference on Computing in High Energy and Nuclear Physics (CHEP 2021)
(2) Novel fully-heterogeneous GNN designs for track reconstruction at the HL-LHC, Sylvain Caillou*, Christophe Collard, Charline Rougier, Jan Stark, Heberth Torres and Alexis Vallier, EPJ Web of Conf., Volume 295, 2024, 26th International Conference on Computing in High Energy and Nuclear Physics (CHEP 2023)
(3) Expected physics and computing performance of the ATLAS ITk GNN-based Track Reconstruction Chain, https://indico.cern.ch/event/1499357/contributions/6621928/
(4) Nouvelles approches pour la construction efficace de graphes pour l’utilisation des Graph Neural Networks au HL-LHC sur architectures CPU et GPU, https://indico.in2p3.fr/event/31391/contributions/142485/
(5) Module Map Graph library, https://doi.org/10.5281/zenodo.20154897
La mise en service du Grand Collisionneur de Hadrons de Haute Luminosité (HL-LHC), prévue en 2030, multipliera par 3-4 le nombre de collisions par croisement de faisceaux par rapport au LHC actuel. Cette augmentation drastique du volume de données représente un défi HTC majeur pour les expériences comme ATLAS : les algorithmes de reconstruction des trajectoires de particules chargées devront identifier leurs traces parmi ~500k points tout en respectant des contraintes strictes de temps de calcul, de ressources matérielles et énergétiques, et de qualité physique des résultats.
Depuis sa fondation en 2019, le Laboratoire des 2 Infinis – Toulouse (L2IT) a construit son identité autour de méthodes d'analyse innovantes. Dans ce cadre, et au travers de la collaboration GNN4Itk, nous avons développé une chaîne de reconstruction de traces basée sur les Graph Neural Networks (GNN) : création rapide d'un graphe connectant les hits d'un évènement de collision, scoring des arêtes du graphe par un GNN, puis segmentation des traces par un algorithme dédié implémenté en CUDA. Ces différentes étapes ont été développées dans des codes distincts, conçus pour valider la faisabilité de chaque brique technologique individuellement, mais difficilement intégrables dans une chaîne de traitement complète et déployable en production.
Le projet MMG++ démarré fin 2025 répond à cette limitation : il constitue une réécriture intégrale de la chaîne en C++20 et CUDA, au sein d'une base de code unifiée, moderne et maintenable. L'ensemble de la chaîne — construction de graphe, inférence GNN et segmentation — est intégré de façon cohérente via un algorithme CUDA unifié, avec une API publique C++ et des bindings Python. Sur le plan des performances, la gestion mémoire repose sur des pools préalloués supprimant les allocations dynamiques par événement ; la construction de graphe est réalisée par un unique kernel CUDA, réduisant les transferts CPU/GPU; l'inférence GNN s'appuie sur le runtime ONNX.
Une attention soutenue a été portée à la qualité logicielle. Le dépôt intègre une chaîne d'intégration continue complète (tests CPU et GPU, mesure de couverture de code, analyse statique SonarQube, packaging, ...), des hooks pre-commit couvrant le formatage C++/Cmake/Python, analyse statique et conformité au standard REUSE.
Les performances de la chaîne complète ont été évaluées à l'été 2026 sur des données simulées représentatives du HL-LHC, en couplage avec la chaîne logicielle officielle d'ATLAS (ACTS/Athena). Ces résultats permettent d'évaluer l'efficacité de reconstruction, le coût énergétique de traitement de chaque évènement, et le débit de traitement afin de conclure sur la compatibilité de cette chaîne d'analyse avec les exigences du HL-LHC. Nous étudions en particulier l'intérêt de déployer la chaîne dans un mode client/serveur avec Triton Inference Server, permettant de mutualiser les ressources GPU, de réduire les coûts d'infrastructure, et de faciliter le déploiement de traitement GPU dans l'infrastructure WLCG.
MMG++ est conçu comme un code générique et pérenne : bien que développé initialement pour le détecteur interne d'ATLAS, son architecture modulaire le rend adaptable à d'autres détecteurs de physique des particules et, à terme, à d'autres architectures matérielles au-delà de CUDA.
Je présenterai l’utilisation du système agentique Hermes pour interroger les données du broker astronomique Fink pour l’observatoire Vera C. Rubin. Les données de Fink sont réparties entre plusieurs systèmes et bases de données, chacun disposant de sa propre interface. Nous avons développé une compétence (skill) Hermes permettant d’accéder à ces différentes sources de manière transparente et de les interroger conjointement. Je décrirai également notre configuration de Hermes, notamment l’orchestration des agents ainsi que le partage des compétences et de la mémoire, au sein d’une même instance comme entre plusieurs instances.
Cette présentation propose un retour du travail effectué par le GT Licences du RI3 sur la manière de choisir une licence pour un projet de développement, qu'il s'agisse de matériel, de logiciel ou de documentation/images.
Comment nous avons mis en place un service qui permet de faire le déploiement des modèles d'IA automatiquement dans Fink.
Les serveurs Windows de L'IRFU étaient pour la plupart des machines virtuelles sur un cluster HyperV obsolète. Le cluster hyperV a été remplacé par une structure Proxmox et nous avons refait (et non migrée) la plus part de nos serveurs . Nous en avons profité pour réétudier toute la sécurité.
- Vérification et nettoyage des différents groupes Admin AD.
- Windows 2025 (Core et Desktop)
- Derniers versions des logiciels ( SQL, SCCM, IIS, …)
- Refonte totale des droits (historique problématique)
- Utilisation des comptes GMSA (comptes de services Génériques sans mot de passe)
Avec l’évolution des technologies et des besoins des expériences, les volumes de données à stocker au CC-IN2P3 ne cessent d’augmenter. Cette croissance s’accompagne d’un enjeu majeur : assurer la gestion et la pérennité des données tout au long de leur existence, tout en limitant l’apparition de données dites « orphelines », dont le contexte, la finalité ou les responsabilités ne sont plus clairement identifiés.
Dans ce contexte, le CC-IN2P3 développe une approche fondée sur le cycle de vie des données, couvrant les différentes étapes d’un projet : la planification et la description des données en amont, leur utilisation et leur gestion pendant le projet, puis leur conservation, leur archivage ou leur suppression à son terme.
Cette présentation proposera un retour d’expérience sur la mise en œuvre de cette approche au CC-IN2P3. Après un rapide état des lieux des volumes de stockage et des problématiques liées aux données orphelines, nous présenterons les différentes étapes du cycle de vie des données ainsi que les outils et services permettant de les accompagner.
Une attention particulière sera portée à la phase de planification, avec la présentation du Data Management Plan (DMP) et de la solution RDMO mise en place et adaptée au CC-IN2P3. Nous aborderons ensuite les différentes solutions de stockage « tiède » proposées aux utilisateurs, adaptés aux différents usages.
Enfin, nous présenterons la gestion du devenir des données en fin de cycle, avec la mise en place de solutions de stockage froid (d’archivage mais j’ai pas le droit de dire le mots), notamment à travers la création d’AIP (Archival Information Package). Nous détaillerons le rôle et la structure de ces paquets d’archivage et présenterons un outil développé au CC-IN2P3 permettant d’automatiser leur création et leur préparation.
L’objectif est de montrer comment une approche intégrée du cycle de vie des données peut permettre de mieux maîtriser les données hébergées au CC-IN2P3, depuis leur création jusqu’à leur archivage ou leur suppression, en associant accompagnement des projets, gestion du stockage et préservation à long terme.
JupyterHub est souvent déployé sur Kubernetes, notamment pour bénéficier de la gestion dynamique des ressources et du déploiement de serveurs Jupyter. Cependant, pour les centres de calcul qui ne disposent pas déjà d’un cluster Kubernetes mutualisé, cette approche implique la mise en place et l’administration d’une infrastructure supplémentaire, avec ses propres ressources.
Il est pourtant possible de s’appuyer sur un cluster Slurm existant et ainsi de mutualiser les ressources avec les autres activités de calcul. Chaque serveur Jupyter est alors lancé comme un job Slurm sur les nœuds de calcul, avec un accès configurable aux CPU, GPU et à la mémoire, et bénéficie du même environnement que les jobs classiques. La gestion des utilisateurs, des droits d’accès et des ressources est ainsi déléguée à Slurm, ce qui simplifie l’administration tout en offrant aux utilisateurs un fonctionnement cohérent avec leurs habitudes sur le cluster.
Cette présentation abordera l’architecture et la stack technique utilisées, notamment BatchSpawner, qui assure l’intégration entre JupyterHub et Slurm. Elle montrera, à travers notre retour d’expérience, qu’il est relativement simple de déployer JupyterHub sur une infrastructure HPC existante et que Kubernetes n’est pas nécessairement la solution adaptée pour tous les centres de calcul.
De plus en plus d'expériences scientifiques s'appuient sur des infrastructures permettant d'orchestrer des applications conteneurisées.
Dans cette présentation nous décrivons les solutions adoptées pour répondre à ce besoin avec une forte contrainte RH (1 à 2 FTE) malgré la complexité de ces technologies.
Cette présentation s'appuie sur le retour d'expérience de la mission spatiale SVOM et l'expérience SKA. Néanmoins, l'approche est également parfaitement adaptée aux déploiements de services d'administrations.
Dans un premier temps, nous aborderons l'approche générique:
Puis nous aborderons certaines spécificités liées aux missions SVOM et SKA:
Au vu de la complexité de l'expertise requise pour ce type de déploiements, nous conclurons sur l'importance de suivre une approche standardisée permettant la réutilisation de "briques".
Cette présentation peut servir de base de discussions sur comment mutualiser les compétences et construire un socle de briques réutilisables selon les besoins.
title: "Je suis, J'existe. Je coupe, Je paie."
author: "BODA Roland, RAMPARISON Adrien"
date: "23-26/11/2026"
institute: "CNRS/IN2P3/IJCLab"
Une des ressources informatiques les plus utilisées dans un laboratoire est le service d'impression.
Pourtant ses coûts financiers et environnementaux sont généralement minimisés voire complètement inconnus par nos utilisateurs.
Nous tenterons par cet exposé de faire un retour d'expérience sur le logiciel commercial de gestion du service d'impression PAPERCUT
et d'un autre 'fait maison' PAPERSTAT, testés au sein d'IJCLAb.
Nous donnerons quelques chiffres sur l'impact financier et environnemental de ce service et proposerons des idées de réflexion à destination des utilisateurs et des décideurs.
Si le temps le permet, mise en station de :
- 2 téléscopes tout automatiques
- 1 téléscope manuel
Les applications online qui gèrent l'acquisition et de contrôle-commande des expériences de physique peuvent être soumises à d'importants flux de données UDP en provenance des cartes d'acquisition électroniques. Ce qui met leurs threads réseau face à une triple contrainte de performance : il faut lire les données au débit où elles arrivent, traiter chaque paquet avec une latence suffisamment faible, et économiser des ressources CPU/RAM pour le reste des traitements.
Au fil des dernières décennies, les noyaux Linux et Windows se sont dotés de nombreuses fonctionnalités qui peuvent aider à atteindre ce triple objectif. Mais de trop nombreuses applications online les dédaignent, restant exclusivement basées sur les APIs réseau historiques de 4.2BSD (1983) et leur cousin Winsock 1.0 (1992) quand on gratte un peu le vernis des abstractions.
La bibliothèque udipe, en cours de développement, souhaite changer cela en facilitant l'accès aux APIs modernes de communication UDP de Linux et Windows. Son interface flexible s'adapte aux besoins de l'utilisateur : du plus simple pour les petits flux réseau peu exigeants, au plus souple pour les grands flux qui nécessitent un contrôle plus fin, les différents styles pouvant être combinés au sein d'une même application.
Une surcouche également en cours de développement ajoute le support du protocole de contrôle-commande IPBus avec une interface compatible avec celle d'udipe. Ce qui permettra à terme d'écrire les opérations d'acquisition et de contrôle commande dans un style homogène, de les synchroniser facilement et efficacement entre elles, et de prioriser les opération réseau de contrôle commande par rapport à celles d'acquisition.
Les logiciels de contrôle, d’acquisition de données ou d’analyse en temps réel sont difficiles à tester car ils nécessitent la présence de matériel physique qui est souvent indisponible (ex: en cours de construction), rare (prototypes uniques) ou coûteux à opérer ; or une batterie de tests rapide et exhaustive est essentielle pour réduire les coûts de développement et d'entretien des logiciels et favoriser la collaboration. L'implémentation de simulateurs virtuels pour chaque composant matériel ne permet pas de passer à l'échelle : tester un logiciel de contrôle pilotant 1 millier de carte d'acquisition ne peut se faire en exécutant 1 millier de simulateurs, le test resterait trop coûteux pour être utile. Une meilleure approche consiste à simuler les réponses matérielles au niveau des interfaces du programme lui-même : il n'y a alors plus besoin de ressources supplémentaires à celle du programme à tester, et tous les matériels utilisant la même interface peuvent alors être simulés. La présentation décrira un design logiciel permettant de rapidement mettre en pratique cette approche : une abstraction des interfaces utilisant simultanément deux bibliothèques — une pour réaliser les échanges via l'interface réelle, et une pour valider les entrées et simuler les réponses lors des tests. Nous présenterons les outils des librairies Phoenix qui permettent de facilement appliquer cette approche à de nouvelles interfaces et qui ont conduit à la création d'un écosystème d'interfaces standardisées, implémentées par des bibliothèques interopérables et les simulateurs correspondants, disponible en plusieurs langages (C++, Rust, Python).
La plateforme Gitlab IN2P3, hébergée et administrée par le CC-IN2P3 depuis 2014, a dû s'adapter à l'essor de l'intégration et du déploiement continus (CI/CD). Initialement, des runners partagés permettaient à la communauté de découvrir Gitlab CI et d'exécuter des pipelines légers. Que ce soit pour compiler du code, déployer des pages Gitlab ou bien construire et publier des images de conteneurs, notamment grâce aux fonctions Docker-in-Docker (DinD), les runners ouvrent de nombreuses perspectives aux utilisateurs de l'usine logicielle.
Face à la croissance des usages, des restrictions d'utilisation ont dû être introduites, afin d'éviter les abus, garantir une certaine équité d'accès aux ressources mais aussi pour des raisons de sécurité (interdiction des runners privilégiés). Ces restrictions incitent les utilisateurs aux besoins les plus exigeants à déployer leurs propres runners.
Cette séance retrace cette évolution et détaille les contraintes actuelles. Elle propose également plusieurs scénarios de déploiements de runners Gitlab, pour différents types d'environnements et de besoins. L'objectif est de repartir dans son équipe avec des pistes solides pour déployer sa propre infrastructure de runners Gitlab, en utilisant des ressources diverses.
Enfin, tout au long de la séance, les échanges et retours d'expérience avec une partie de l'équipe des administrateurs Gitlab IN2P3 et des utilisateurs de la plateforme seront vivement encouragés.
Cette piscine proposera une introduction pratique au développement logiciel assisté par IA. À travers un cas d’usage scientifique concret et accessible, les participants découvriront comment intégrer des assistants et agents IA dans leur workflow de développement, de la conception à l'implémentation.
L’atelier abordera notamment le développement avec des agents, la gestion du contexte et des règles du projet, le prompting, ainsi que les bonnes pratiques permettant de tirer parti de ces outils tout en conservant un workflow de développement maîtrisé.
Les modèles et l’infrastructure utilisés pour l’atelier sont encore en cours de définition. Selon les solutions disponibles au moment des JI, différentes modalités pourront être proposées : modèles exécutés localement sur votre laptop ou au CC ou services accessibles à distance.
Pré-requis : des notions de base en programmation et en gestion de code source sont recommandées. Les modalités de préparation et de configuration seront précisées en amont de la piscine.
Il existe une grande diversité parmi les auteurs de logiciels dans nos instituts : scientifiques, chercheurs, électroniciens, ingénieurs logiciel, etc. Même au sein du corps des ingénieurs informaticiens, les spécialités sont très pointues et nombreuses : expert en calcul, développement web, contrôle-commande, acquisition de données, systèmes embarqués, science des données, apprentissage automatique... Chaque discipline a des besoins spécifiques et utilise souvent des outils dédiés, indispensables à ses activités. Les problèmes apparaissent lorsque les différentes disciplines doivent collaborer pour développer la suite logicielle complète d'un détecteur : outils redondants ou incompatibles, fonctionnalités dupliquées, conversions en cascade pour s'adapter à différents formats... Ces problèmes nuisent considérablement à la portée des logiciels produits : ils limitent la taille des communautés qui les développent et les utilisent, et entravent les utilisations transverses des solutions produites.
Aujourd'hui, des solutions existent pour permettre à chacun de travailler avec ses outils de prédilection, tout en standardisant les pratiques de développement et en assurant une livraison homogène des logiciels afin de faciliter la collaboration. La présentation couvrira l'ensemble de la chaîne de production logicielle, de l'architecture logicielle et la gestion des interfaces à l'intégration et la livraison continue. Grâce au gestionnaire de paquets Pixi et à l'intégration continue de GitLab, nous verrons comment, partant d'un prototype unique, faire émerger un écosystème de solutions utilisant plusieurs technologies, sans imposer de contraintes aux utilisateurs. Nous prendrons pour exemples les bibliothèques Phoenix et l'école Gray Scott, qui illustrent concrètement la mise en place de ces pratiques.
Nous présentons Allen Core, un framework pour le traitement de données en temps réel sur des architectures de calcul hétérogènes, développé à partir d’Allen, le logiciel de traitement et d’analyse en temps réel des données de l’expérience LHCb, conçu pour s’exécuter sur des architectures basées sur des GPU.
En généralisant et en modularisant certains des composants d’Allen, nous avons développé un framework permettant de réutiliser cette technologie dans d’autres expériences et applications. Allen Core fournit ainsi une architecture flexible et extensible pour le développement d’algorithmes de traitement de données en temps réel, tout en permettant leur exécution sur différentes architectures matérielles.
Cette approche vise à faciliter la réutilisation des algorithmes et des infrastructures développés pour LHCb et à permettre leur adaptation à de nouveaux contextes expérimentaux nécessitant un traitement de données à haut débit
On présentera ici l'évolution d'un code en C++ avec Qt, conçus par M. Ageron et dont je veille à l'évolution.
Les contraites sont :
- Temps réel
- Multiples interfaces avec des protocoles différents (SNMP, Modbus, RS232...) et des librairies fabriquants
- Réseau distinct extérieur
- Redondances des équipements
Cela pose diverses difficultés pour son développement (et pour les tests).
Le projet Nyx est un écosystème logiciel léger destiné au contrôle-commande d’instruments scientifiques distribués, avec plusieurs devices et plusieurs clients. Il est conçu pour être simple et rapide à prendre en main. Les messages de contrôle-commande sont encodés en JSON et transportés via MQTT.
La pile Nyx est développée en C11 et dispose de couches pour POSIX, Windows et Arduino. Des encapsulations en C++ et Python sont également fournies. Sa faible empreinte permet son utilisation aussi bien sur des ordinateurs classiques que sur des microcontrôleurs tels que les ESP32 ou Cortex-M.
Les devices Nyx sont autodescriptifs : ils exposent eux-mêmes la structure de leur interface de contrôle-commande. Cette interface peut être conçue graphiquement à l’aide de Nyx Assistant, qui génère automatiquement le squelette du code, laissant au développeur l’implémentation du code métier.
Le projet comprend également Nyx Lab, une interface desktop et Web permettant de piloter les devices Nyx. Les interfaces utilisateur sont elles aussi composées graphiquement. Un système d’addons permet d’ajouter des contrôles graphics ou des panels applicatifs.
Nyx est à l’origine un projet personnel inspiré d’INDI (Instrument Neutral Distributed Interface), un protocole issu du monde de l’astronomie amateur qui repose sur des échanges XML sur TCP. Une passerelle bidirectionnelle Nyx ↔ INDI assure l’interopérabilité entre les deux protocoles.
La collaboration internationale LSST (plus de 4 000 personnes, une trentaine de pays) vise à imager tout le ciel austral toutes les 4 nuits pendant au moins 10 ans depuis l'observatoire Vera C. Rubin (Chili), équipé de la plus grande caméra du monde : 3,2 gigapixels, 189 CCD et 6 filtres (ugrizy) de 75 cm et jusqu'à 40 kg, dont 5 embarqués simultanément.
La France, via l'IN2P3, est un contributeur majeur du projet à travers plusieurs laboratoires. L'une de ces contributions est le changeur de filtres automatique de la caméra, lui-même découpé en trois sous-systèmes (carousel, loader, autochanger). C'est un système critique : sans changement de filtre, pas d'observation.
Le logiciel de contrôle du changeur de filtres représente environ 70 000 lignes de Java, développées sur une dizaine d'années par plusieurs générations d'ingénieurs. Il couvre la communication entre les éléments du système, la logique de contrôle et l'interface graphique.
Dans cet exposé, je présenterai rapidement le projet LSST, avant de me concentrer sur mon travail autour du logiciel du changeur de filtres : développements menés lors de la mise en service, validation (tests, simulation et essais sur prototype), outils de suivi du matériel, refactorisation et maintenance du code, et organisation d'une équipe répartie entre plusieurs laboratoires.
Osman Aidel présentera les principes de l'extension TimscaleDB pour Postgres et je présenterai comment nous l'avons utilisé, couplée à Grafana, pour réaliser le monitoring de l'expérience GRAND.
Le logiciel de recherche demeure souvent un sous-produit de la recherche, valorisé principalement lorsqu'il contribue à la publication d'un article scientifique. Afin de remédier à cette situation, nous proposons une première mise en œuvre à travers deux cas d'usage, visant à constituer un catalogue des logiciels au sein d'un laboratoire et d'une communauté scientifique. Cette présentation expose les objectifs poursuivis, les outils mobilisés, ainsi qu'un premier état des réalisations, encore en cours.
Cette démarche s'appuie sur deux projets européens complémentaires. Le projet EVERSE fournit des ressources et des outils destinés à améliorer la qualité des logiciels de recherche, notamment par l'analyse et la visualisation d'indicateurs de qualité. Le projet Codemetasoft vise, quant à lui, à promouvoir la qualité des métadonnées des logiciels de recherche, en s'appuyant sur le standard CodeMeta et sur des outils facilitant la création et la maintenance des fichiers codemeta.json.
Ce projet poursuit trois objectifs : faciliter la publication des logiciels produits et le respect des principes FAIR, afin d'améliorer leur réutilisation au sein de la communauté et au-delà ; mettre en place des outils de qualité logicielle tout en limitant le temps d'ingénierie nécessaire à leur déploiement ; renforcer la visibilité des logiciels produits.
Ces objectifs sont illustrés par deux cas d'usage concrets : la constitution d'un catalogue des logiciels au LAPP, et l'intégration à la démarche de curation de la communauté ESCAPE au sein du catalogue OSSR. Cette mise en oeuvre ouvre la perspective d'une réutilisation par d'autres laboratoires, voire à l'ensemble de l'institut.
L'objectif de ce travail est de définir une méthode et une architecture de référence permettant de gérer le cycle de vie d’une infrastructure d’acquisition selon les principes Infrastructure as Code + GitOps + Nix, avec un niveau de reproductibilité et de traçabilité supérieur aux méthodes traditionnelles.
Cette dernière décennie a vu le mouvement DevOps profondément transformé les pratiques de développement logiciel en incitant les chercheurs et ingénieurs développeurs à livrer leurs applications accompagnées d’images de conteneur ou de fichiers de reconstruction (ex. Dockerfile, Singularity Definition File). Ces machines virtuelles légères permettent aujourd'hui un déploiement simplifié et instantané, dans un environnement d’exécution identique à celui du développeur, sans nécessiter d'intervention manuelle pour installer et configurer des dépendances spécifiques. Si Docker est devenu l’outil emblématique de ce mouvement, notamment dans le monde du cloud, son adoption dans le calcul haute performance (HPC) et les grilles de calcul reste limitée au profit d’alternatives comme Apptainer (ex-Singularity), Shifter ou Enroot, mieux adaptées aux contraintes des super-calculateurs équipés de plus en plus avec des cartes GPUs.
Dans ce contexte, un des groupes de travail DecaLog, ComputeOps, cherche à accompagner des projets de développement qui visent à préparer l’usage des conteneurs intensivement et efficacement dans les disciplines de la physique des particules et nucléaire (HEP), en répondant à des enjeux critiques: tant sur le plan de la sécurité, de l'optimisation des performances, que de l'interopérabilité. L’objectif principal est de permettre aux chercheurs de bénéficier de la souplesse technologique des conteneurs tout en garantissant leur "full" compatibilité avec les infrastructures HPC et grilles de calcul du CNRS et de ses partenaires externes (ex. les mésocentres, les centres de calcul européens EuroHPC JU, CERN, EGI).
Depuis que j'ai repris la coordination de ComputeOps début 2025, les tendances dans les mondes du HPC, de la conteneurisation et de la virtualisation ont été marquées par plusieurs évolutions majeures avec une intégration croissante des conteneurs dans les infrastructures de calcul intensif où la convergence entre le cloud, l’IA et le HPC traditionnel devient incontournable. Une autre tendance notable est arrivée dans la même celle de l'émergence du standard "Kubernetes" dans une approche visant à simplifier les workflows DevOps et à réduire la complexité des orchestrations, tout en maintenant une compatibilité avec les infrastructures hétérogènes pour garantir une exécution optimale en production. ComputeOps va continuer à explorer l’utilisation les deux orchestrateurs les plus dominants dans les grands centres de calcul pour du cloud computing et de l'HPC, respectivement Kubernetes et Slurm, adoptant aujourd'hui des stratégies mixtes dans l'orchestration hybride (Slurm pour les workloads batch/MPI, Slinky et Kubernetes pour les services conteneurisés comme KubeHPC, Dapr, KubeRay ou Caikit) qui gagnent en popularité, notamment pour optimiser l’allocation des ressources GPU et la proximité des données (data locality).
Enfin, ComputeOps commence à réflechir l'intégration de la dimension intelligence artificielle pour optimiser les benchmarks, sécuriser les workflows et améliorer les performances. L’IA serait pour:
En alignement avec les initiatives européennes (EGI, EOSC, CERN) et les standards Dev{Sec}Ops, ComputeOps vise à moderniser les workflows scientifiques au CNRS en offrant une solution sécurisée, performante et interopérable pour le déploiement d’applications en conteneur dans le domaine de la physique des particules et nucléaire.
Aussi je présenterai à cette occasion le status update du groupe de travail sur nos activités et le bilan de nos travaux et projets en cours (CSAN) et en prospection.
Snakemake est un outil de workflow management en Python, idéal pour automatiser des pipelines complexes et les déployer à l'échelle. Venant du monde de la bioinformatique, il se diffuse peu à peu dans notre communauté avec notamment des hackathons annuels organisés au Cern.
Après avoir présenté cet outil, j'illustrerai son utilisation sur un cas d'usage en cosmologie (traitement de ~600To de données par ~30k jobs), implémenté avec succès au CCIN2P3 dans le cadre de la collaboration ZTF. J'évoquerai enfin ses points forts et quelques limitations.
Dans le cadre de l'évolution de ses infrastructures informatiques, l'Institut de Recherche sur les lois Fondamentales de l'Univers (IRFU) procède au déplacement de deux de ses plateformes de calcul haute performance (HPC) ainsi que de sa grille de calcul vers le TGCC (Très Grand Centre de Calcul). Le TGCC, l'un des trois centres de calcul nationaux, est une entité dépendant du Commissariat à l'Énergie Atomique et aux Énergies Alternatives (CEA). Cette présentation traitera des différents aspects de ce projet (administratif, technique...).
Mise en place de la nouvelle infrastructure proxmox/ceph hébergée sur 3 batiments
A IJCLab, depuis la migration de notre NetApp vers un cluster Ceph,en 2025/2026 nous sauvegardons
principalement des volumes CephFS, soit 400 TB de données dont environ 150 TB au CC, avec le logiciel Networker, logiciel de backup historique du Lal, un outil propriétaire avec coût licence
annuelle et un avenir incertain puisque notre prestataire nous a incité à migrer vers Veeam.
C'est ainsi que j'étudie depuis cet été Une alternative libre : Bareos.
puisque nous ne voulons plus dépendre d'un éditeur.
Bareos. Fork de Bacula créé en 2010. Bacula,existe depuis 2000, est utilisé de manière satisfaisante dans la communauté de l'enseignement supérieur et de la recherche (notamment à l'université PSL
depuis 2014, avec 1,5 PB de sauvegardes, et par le laboratoire cnrs cermav à Grenoble depuis 2007).Bareos repose sur une architecture ouverte et modulaire, sans licence par volume ni par client,
avec la possibilité de souscrire un support professionnel. Il propose une interface ligne de commande (bconsole) et une interface web (WebUI) incluse dans la distribution, alors que Bacula ne la propose
que via des outils tiers. Son catalogue repose sur une base PostgreSQL, et sa configuration en fichiers texte est facile à versionner.
Architecture Bareos. Elle repose sur trois composants indépendants, répartis sur des machines distinctes :
• le Director orchestre les jobs, les plannings et les pools, et gère le catalogue (base PostgreSQL) ;
• le Storage Daemon reçoit et écrit les données sur le stockage (disque, bande).
• le File Daemon, installé sur le client, lit les fichiers à sauvegarder.
Les données sont organisées en pools (par exemple un pool pour les Full, un autre pour les incrémentales, chaque pool ayant sa durée de rétention.
Tests Bareos / NetWorker.
Temps de sauvegarde, de restauration de volumes Cephfs volumineux...
A tester, sauvegarde annuaire AD, VM hyperV
conteneurs docker,kubernetes...
(Résultats des tests seront publiés lors de la présentation).
Avantage clé : la VirtualFull. Pour un volume 20 TB (notre cas parfois) une Full classique est très longue et coûteuse en ressource de production. La VirtualFull se reconstitue à partir de la full, des incrémentales et différentielles au sein du serveur de stockage : aucune sollicitation du client sur passerelle de stockage de production Ceph, aucun trafic réseau.
Sécurité prévisionnelle. Sauvegarde sur cluster Ceph dédié sur un montage rados en erasure coding et sur bandes LTO-9 en différée, avec mise au coffre des bandes pour résister à une attaque.
Conclusion. Bareos est une alternative libre, ouverte et éprouvée face à NetWorker,sous réserve de tests complets en fonction de tous les besoins d'IJCLAB.